
هک OpenAI با کمک Claude؛ ماجرای نفوذ Hacktron AI چه بود؟ در آکادمی لیان تریدر بررسی می کنیم.
گزارش تازهای درباره یک رخداد امنیتی مرتبط با OpenAI منتشر شده که در آن یک تیم سهنفره از پژوهشگران امنیتی شرکت Hacktron AI توانستهاند با کمک مدل Claude از شرکت Anthropic، زنجیرهای از آسیبپذیریها را شناسایی و آزمایش کنند.
این نفوذ در قالب پژوهش امنیتی و برنامه باگبانتی انجام شده و هدف آن سرقت اطلاعات یا آسیبزدن به OpenAI نبوده است.
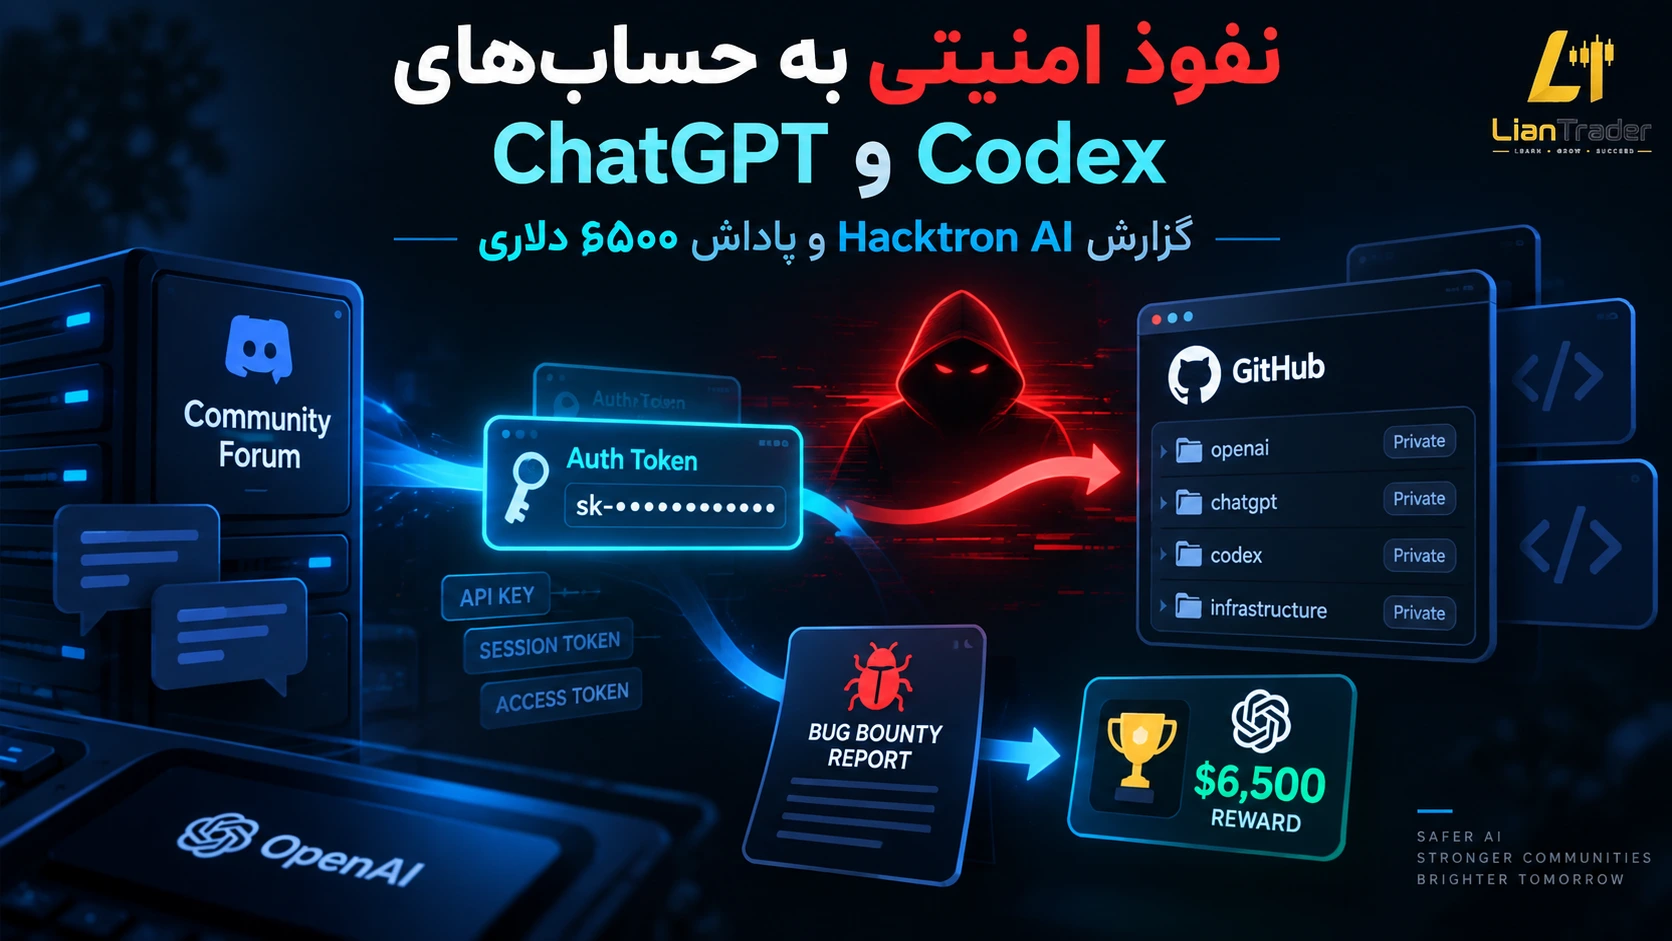
طبق اطلاعات منتشرشده، این اتفاق در ۲۵ ژوئیه ۲۰۲۶ رخ داده و تیم Hacktron AI توانسته در کمتر از ۷۲ ساعت از یک آسیبپذیری اولیه در زیرساخت انجمن کاربران OpenAI به سطحی از دسترسی برسد که شامل حساب ChatGPT و Codex یکی از کارکنان این شرکت میشد.
پژوهشگران در ادامه توانستند وجود دسترسی به محیط داخلی کد OpenAI را نیز اثبات کنند.
هک OpenAI از کجا شروع شد؟
شروع ماجرا به خود ChatGPT یا مدلهای اصلی OpenAI مربوط نبود.
اولین آسیبپذیری در زیرساخت انجمن کاربران این شرکت شناسایی شد؛ انجمنی که از نرمافزار Discourse استفاده میکرد.
مشکل در بخش پردازش تصاویر وجود داشت و پژوهشگران متوجه شدند میتوان از این ضعف برای اجرای کد در سرور استفاده کرد.
اما این آسیبپذیری بهتنهایی برای رسیدن به حسابهای داخلی OpenAI کافی نبود.
تیم Hacktron در ادامه ضعف دیگری را در ساختار ورود و احراز هویت پیدا کرد.
ترکیب این دو مشکل باعث شد حمله از سطح یک انجمن عمومی فراتر برود و به حسابهای متصل به سرویسهای دیگر برسد.
نقش Claude در هک OpenAI چه بود؟
بخش جالب این ماجرا استفاده پژوهشگران از مدلهای Claude برای توسعه و تکمیل آزمایش امنیتی بود.
در مرحله اول، تیم از Claude Opus 4.8 کمک گرفت. این مدل توانست بخشی از مشکل را تحلیل کند، اما در عبور از برخی مکانیزمهای امنیتی حافظه موفق نبود.
پس از انتشار Claude Opus 5، پژوهشگران مدل جدید را امتحان کردند و طبق گزارش خودشان، این نسخه توانست در مدت کوتاهتری به توسعه یک نمونه عملی کمک کند.
نتیجه آن شد که تیم توانست بخش پیچیدهتری از زنجیره نفوذ را تکمیل کند.
با این حال، درست نیست بگوییم Claude بهصورت مستقل OpenAI را هک کرده است.
Claude در این ماجرا نقش ابزار کمکی را داشت و تمام مراحل توسط پژوهشگران انسانی هدایت شده بود.
پژوهشگران تا کجا به سیستمهای OpenAI دسترسی پیدا کردند؟
پس از تکمیل زنجیره آسیبپذیری، پژوهشگران توانستند به حساب ChatGPT و Codex یکی از کارکنان OpenAI دسترسی پیدا کنند.
این موضوع اهمیت زیادی داشت، زیرا چنین حسابهایی ممکن است به سرویسهای دیگری مانند GitHub، Slack یا ایمیل سازمانی متصل باشند.
در نتیجه تصاحب یک حساب میتواند در شرایط خاص مسیر دسترسی به سرویسهای بیشتری را باز کند.
برای اثبات میزان دسترسی، تیم Hacktron یک درخواست تغییر آزمایشی در محیط کد داخلی OpenAI ایجاد کرد.
همین کار نشان داد که سطح دسترسی فراتر از یک حساب ساده کاربری بوده است.
پژوهشگران پس از اثبات آسیبپذیری، ادامه آزمایش را متوقف کردند و موضوع را از مسیر رسمی به OpenAI گزارش دادند.
آیا اطلاعات کاربران ChatGPT سرقت شد؟
هک چت جی پی تی توسط کلاد
طبق اطلاعات منتشرشده، نشانهای از سرقت گسترده اطلاعات کاربران یا دستیابی به وزنهای مدلهای هوش مصنوعی OpenAI گزارش نشده است.
تیم Hacktron اعلام کرده پس از رسیدن به سطح کافی برای اثبات مشکل، از مشاهده یا استخراج اطلاعات حساس خودداری کرده است.
بنابراین این رخداد را نباید با یک نشت بزرگ اطلاعاتی یا سرقت مدلهای OpenAI اشتباه گرفت.
البته همین سطح دسترسی آزمایشی نیز نشان میدهد که یک ضعف در سرویس جانبی میتواند در صورت ترکیب با آسیبپذیریهای دیگر به نقاط حساستر سیستم برسد.
واکنش OpenAI به این رخداد امنیتی
پس از دریافت گزارش، OpenAI اقداماتی برای بستن مسیر حمله انجام داد.
جلسات و توکنهای تحت تأثیر لغو شدند، سطح دسترسی برخی توکنهای مربوط به انجمن محدودتر شد و آسیبپذیری مرتبط با پردازش تصویر نیز برطرف شد.
Discourse نیز اصلاحات لازم را روی سیستم پردازش تصاویر اعمال کرد تا استفاده مشابه از این ضعف در آینده دشوارتر شود.
در نهایت OpenAI برای گزارش مسئولانه این آسیبپذیریها مبلغ ۶۵۰۰ دلار به تیم Hacktron AI پرداخت کرد.
چرا پاداش ۶۵۰۰ دلاری خبرساز شد؟
مبلغ پرداختی OpenAI یکی از بخشهایی بود که توجه زیادی در جامعه امنیت سایبری جلب کرد.
با توجه به اینکه پژوهشگران توانسته بودند به حساب یک کارمند و محیط داخلی کد دسترسی پیدا کنند، برخی کاربران این مبلغ را پایین ارزیابی کردند.
با این حال، پاداش باگبانتی همیشه فقط براساس بیشترین سطح دسترسی محاسبه نمیشود.
محدوده برنامه، نوع آسیبپذیری، سرویس درگیر و اینکه بخشی از مشکل مربوط به یک نرمافزار شخص ثالث بوده یا نه، همگی میتوانند روی مبلغ نهایی اثر داشته باشند.
آیا این یک حمله واقعی بود یا هک کلاهسفید؟
این عملیات در دسته هک کلاه سفید قرار میگیرد.
تیم Hacktron AI با هدف سرقت اطلاعات یا تخریب زیرساخت وارد عمل نشده بود.
آنها آسیبپذیریها را پیدا کردند، سطح خطر را اثبات کردند و سپس موضوع را گزارش دادند.
به همین دلیل این اتفاق بیشتر یک تست امنیتی واقعی و جدی محسوب میشود تا حمله مجرمانه.
تفاوت اصلی این است که در یک حمله مخرب، مهاجم ممکن است اطلاعات را سرقت کند، دسترسی را مخفی نگه دارد یا از آن برای اخاذی استفاده کند. در این مورد چنین رفتاری گزارش نشده است.
این اتفاق درباره آینده امنیت هوش مصنوعی چه چیزی نشان میدهد؟
مهمترین بخش این ماجرا شاید خود OpenAI نباشد، بلکه نقشی باشد که مدلهای هوش مصنوعی در پژوهشهای امنیتی پیدا کردهاند.
تا چند سال قبل، توسعه یک نمونه پیچیده برای سوءاستفاده از یک آسیبپذیری میتوانست نیازمند ساعتها یا روزها کار تخصصی باشد.
مدلهای جدید میتوانند بخشهایی از تحلیل کد، بررسی خطاهای حافظه، ساخت نمونههای آزمایشی و پیدا کردن مسیرهای حمله را سریعتر کنند.
این قابلیت برای پژوهشگران امنیتی بسیار ارزشمند است، زیرا میتواند باعث شود ضعفها قبل از سوءاستفاده مهاجمان پیدا شوند.
اما همین توانایی میتواند در اختیار هکرهای مخرب نیز قرار بگیرد.
به همین دلیل احتمالاً در سالهای آینده استفاده از هوش مصنوعی هم در حمله و هم در دفاع سایبری افزایش خواهد یافت.
چرا امنیت حسابهای متصل به Codex مهم است؟
ابزارهایی مانند Codex دیگر فقط یک چتبات ساده نیستند. این سرویسها میتوانند به مخازن کد، فایلها و ابزارهای کاری سازمانی متصل شوند.
هرچه یک حساب به سرویسهای بیشتری دسترسی داشته باشد، اهمیت امنیت آن نیز بیشتر میشود.
اگر مهاجم بتواند چنین حسابی را تصاحب کند، ممکن است از همان سطح دسترسی برای حرکت به سیستمهای دیگر استفاده کند.
این اتفاق نشان داد شرکتها باید دسترسی ابزارهای هوش مصنوعی را دقیقاً مانند حسابهای حساس سازمانی مدیریت کنند و فقط حداقل مجوز لازم را در اختیار آنها قرار دهند.
آیا Claude واقعاً OpenAI را هک کرد؟
بهصورت دقیق، خیر.
Claude خودش تصمیم نگرفت OpenAI را هدف قرار دهد و بهصورت خودکار حملهای را آغاز نکرد.
پژوهشگران Hacktron AI از Claude بهعنوان یک ابزار برای کمک در تحلیل و توسعه نمونه امنیتی استفاده کردند.
بنابراین عبارت دقیقتر این است که پژوهشگران امنیتی با کمک Claude توانستند زنجیرهای از آسیبپذیریها را در زیرساخت مرتبط با OpenAI شناسایی و اثبات کنند.
این تفاوت مهم است، زیرا هنوز نقش انسان در هدایت چنین عملیاتهایی اساسی است.
آیا این اتفاق میتواند برای کاربران ChatGPT خطرناک باشد؟
طبق اطلاعات منتشرشده، این رخداد به معنی در معرض خطر قرار گرفتن همه کاربران ChatGPT نیست.
مسیر حمله به مجموعه خاصی از ضعفها در انجمن، احراز هویت و حسابهای متصل مربوط بود.
OpenAI نیز پس از گزارش، اقدامات اصلاحی لازم را انجام داد.
با این حال، این اتفاق یادآوری میکند که امنیت یک سرویس بزرگ فقط به خود محصول اصلی وابسته نیست.
انجمن، سیستم ورود، ابزارهای جانبی و سرویسهای متصل نیز میتوانند به بخشی از زنجیره خطر تبدیل شوند.
سوالات متداول درباره هک OpenAI با Claude
آیا OpenAI واقعاً هک شد؟
بله، پژوهشگران توانستند بهصورت آزمایشی به حسابهای مرتبط با OpenAI و بخشی از محیط داخلی دسترسی پیدا کنند، اما این کار در قالب پژوهش امنیتی کلاهسفید انجام شد.
چه کسی OpenAI را هک کرد؟
یک تیم سهنفره از پژوهشگران امنیتی Hacktron AI این عملیات را انجام داد.
Claude چه نقشی در این ماجرا داشت؟
Claude به پژوهشگران برای تحلیل آسیبپذیری و توسعه نمونه عملی کمک کرد، اما حمله بهصورت مستقل توسط مدل انجام نشد.
آیا اطلاعات کاربران ChatGPT سرقت شد؟
طبق گزارشهای منتشرشده، نشانهای از سرقت گسترده اطلاعات کاربران یا مدلهای اختصاصی OpenAI وجود ندارد.
این اتفاق چه زمانی رخ داد؟
نفوذ آزمایشی در ۲۵ ژوئیه ۲۰۲۶ انجام شد و جزئیات آن در سپتامبر ۲۰۲۶ منتشر شد.
پژوهشگران چقدر پاداش گرفتند؟
OpenAI مبلغ ۶۵۰۰ دلار بهعنوان پاداش باگبانتی پرداخت کرد.
آیا مشکل امنیتی برطرف شده است؟
طبق اطلاعات منتشرشده، OpenAI و Discourse آسیبپذیریهای گزارششده را اصلاح کردهاند و دسترسیهای تحت تأثیر نیز لغو شدهاند.
جمع بندی
ماجرای هک OpenAI با کمک Claude را نباید فقط یک رقابت میان دو شرکت بزرگ هوش مصنوعی دید.
اهمیت اصلی این اتفاق در این است که نشان میدهد مدلهای هوش مصنوعی تا چه اندازه در تحلیل امنیتی قدرتمند شدهاند.
تیم Hacktron AI در کمتر از ۷۲ ساعت توانست چند ضعف مختلف را به یکدیگر متصل کند، به حساب یکی از کارکنان OpenAI دسترسی پیدا کند و وجود دسترسی به محیط کد داخلی را اثبات کند.
در نهایت آسیبپذیریها گزارش و اصلاح شدند و OpenAI نیز پاداش ۶۵۰۰ دلاری پرداخت کرد.
این اتفاق یک هشدار جدی برای شرکتهای فناوری است؛ زیرا همان ابزارهایی که میتوانند برای افزایش بهرهوری استفاده شوند، ممکن است فرآیند کشف و بهرهبرداری از آسیبپذیریها را نیز سریعتر کنند.